AI는 과연 코딩에서 만능인가 #2
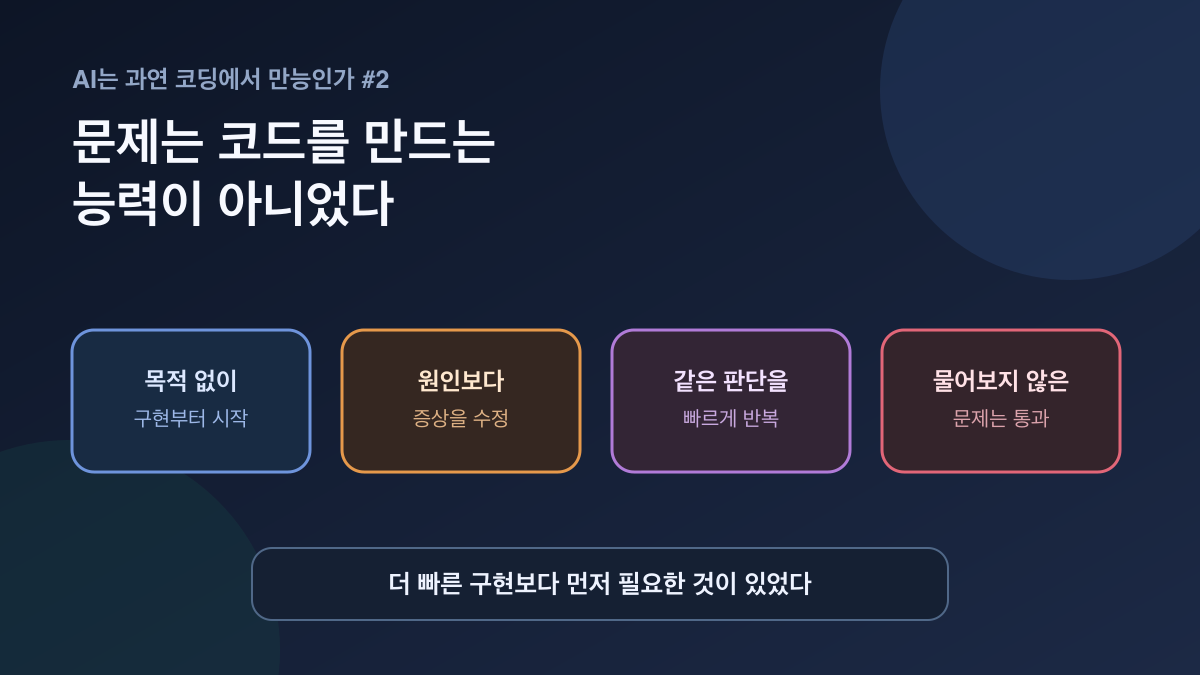
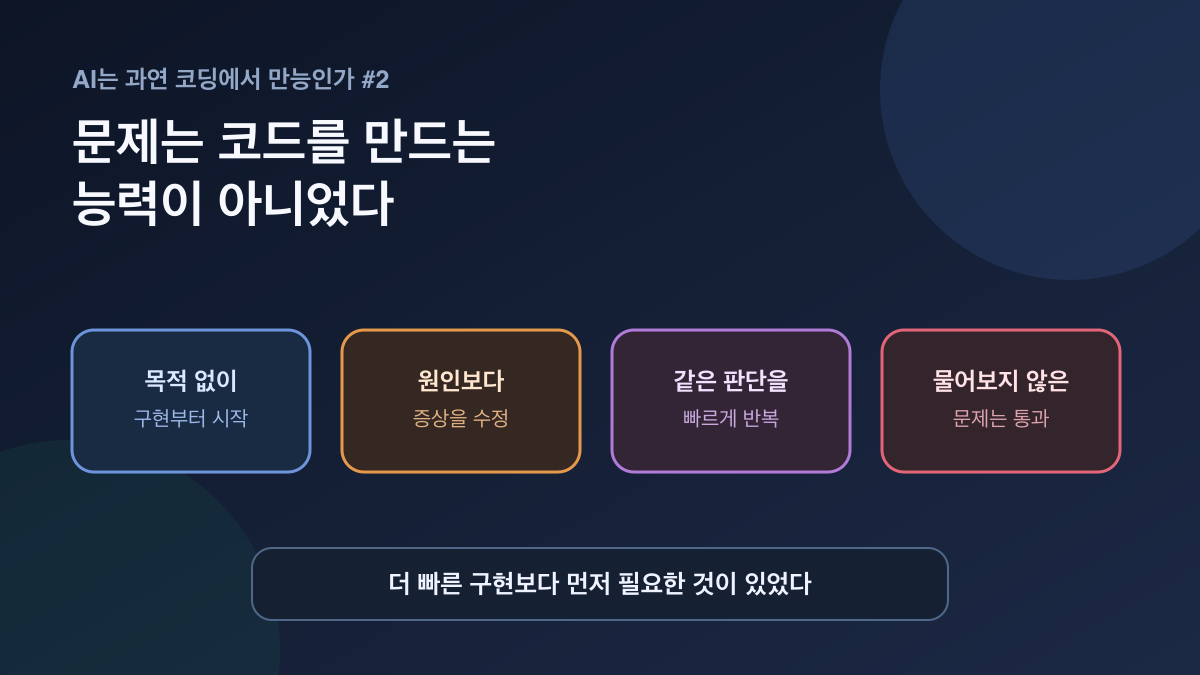
문제는 코드를 만드는 능력이 아니었다.
이전 글에서는 AI에게 개발을 맡길수록 프로젝트에 대한 통제력을 잃을 수 있다는 이야기를 했습니다.
당시에는 통제력을 잃는 지점을 영향도, 코드 규칙, 비즈니스 로직, 연결성으로 나누었습니다. 그런데 실제 프로젝트를 계속 진행하면서 조금 더 근본적인 문제가 보이기 시작했습니다.
AI가 코드를 못 만드는 것이 아니었습니다.
오히려 코드는 너무 빨리 만들었습니다. 제가 목적과 기준을 충분히 정하지 않았는데도 AI는 구현을 시작할 수 있었고, 그 결과가 당장 동작 하기도 했습니다.
문제는 그 다음이었습니다.
왜 이렇게 만들었는지, 이 결과가 어떤 기준을 만족한 것인지, 지금 발견한 문제가 원인인지 증상인지가 점점 흐려졌습니다.
목적이 없어도 개발은 시작된다
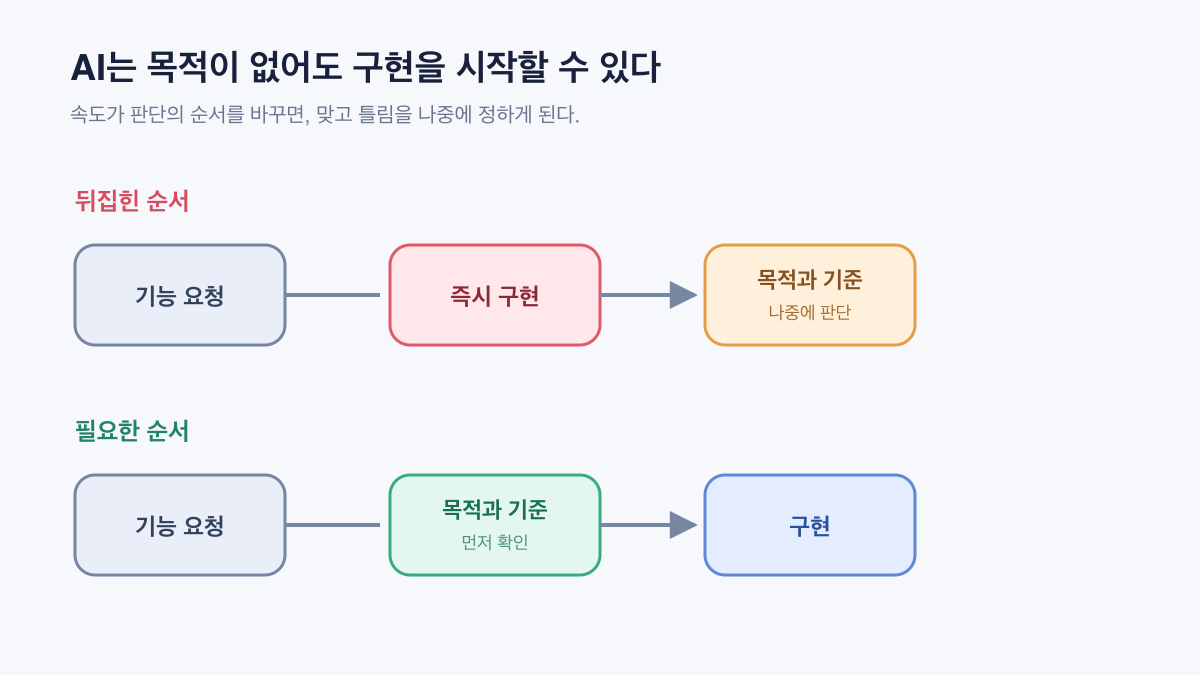
사람과 설계를 논의할 때는 보통 먼저 묻습니다.
왜 필요한가, 무엇이 달라져야 하는가, 무엇을 만족하면 끝났다고 볼 것인가.
그런데 AI와 대화할 때는 이 과정이 너무 쉽게 사라졌습니다. 기능을 설명하면 AI는 곧바로 구조를 제안하고, 파일을 만들고, 코드를 작성합니다.
처음에는 이것이 빠르다고 느껴졌습니다.
하지만 목적이 없는 구현은 무엇이 맞는지 판단할 기준도 없습니다. 코드가 동작한다는 사실만 남고, 그 동작이 제가 원한 결과인지는 나중에 다시 생각해야 했습니다.
저는 원래 목적과 기준을 먼저 정한 뒤 개발하는 편입니다. 그런데 AI의 속도에 맞추다 보니 그 순서가 뒤집히는 일이 생겼습니다.
개발이 빨라진 것이 아니라, 판단해야 할 일이 뒤로 밀린 것이었습니다.
AI는 원인보다 눈앞의 증상에 먼저 반응한다
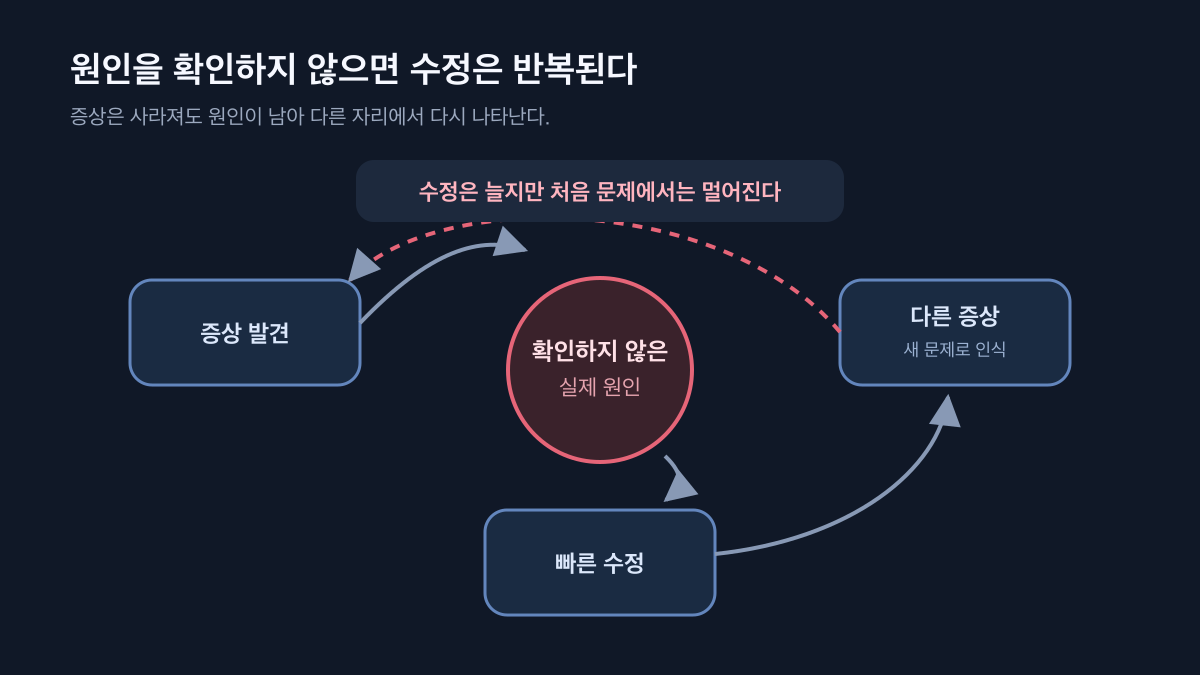
기능이 이상하게 동작한다고 말하면 AI는 빠르게 원인을 설명합니다. 설명도 상당히 그럴듯합니다.
문제는 실제 원인을 확인하기 전에 수정부터 시작한다는 점입니다.
저도 프로젝트를 진행하면서 AI가 제시한 원인을 여러 번 다시 지적했습니다. 화면 배치가 문제라고 했지만 실제로는 값이 채워지지 않은 문제였고, 구조를 바꿔야 한다고 했지만 이미 있는 구조를 제대로 사용하지 않은 문제이기도 했습니다.
이런 경우 AI가 고친 것은 원인이 아니라 눈앞의 증상이었습니다.
증상은 잠시 사라집니다. 하지만 원인은 남아 있기 때문에 다른 자리에서 다시 나타납니다. 그때 AI는 새 문제라고 판단하고 또 다른 수정을 제안합니다.
수정이 반복될수록 코드는 늘어나지만, 처음 문제에서 멀어집니다.
여기서 필요한 것은 더 좋은 코드를 빠르게 만드는 능력이 아니었습니다.
수정하기 전에 무엇을 확인해야 하는지 정해두는 일이었습니다.
반복한다고 반드시 나아지는 것은 아니다
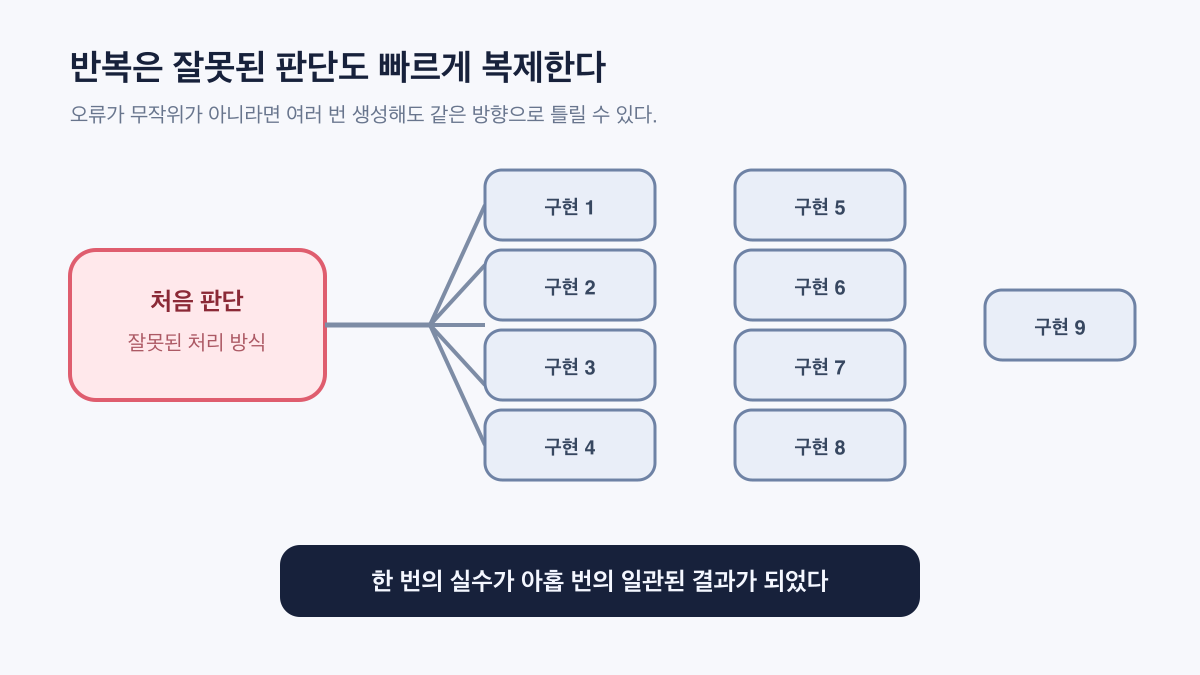
AI는 반복 작업에 강하다고 말합니다. 같은 형식의 코드를 여러 곳에 적용하는 일은 실제로 매우 빠릅니다.
그러나 첫 판단이 틀렸다면 이야기가 달라집니다.
한 프로젝트에서는 같은 잘못된 처리 방식이 아홉 군데에 반복되었습니다. 결과의 차이도 거의 없었습니다. AI가 매번 조금씩 다른 실수를 한 것이 아니라, 같은 판단을 일관되게 복제한 것입니다.
이 경우 반복은 오류를 줄이지 않습니다. 오히려 오류를 빠르게 퍼뜨립니다.
여러 번 다시 생성하거나 다른 AI에게 한 번 더 물어본다고 반드시 해결되는 것도 아닙니다. 모두 같은 정보와 같은 질문을 받으면 같은 방향으로 답할 수 있기 때문입니다.
반복이 결과를 개선하려면 매번 새로운 정보가 들어가야 합니다.
- 실제 요구사항
- 기존 코드와 데이터의 상태
- 사용자가 확인한 목적
- 실패와 성공을 가르는 기준
- 이전 판단이 틀렸다는 증거
이 정보가 다음 작업에 들어가지 않는다면, 열 번의 반복은 한 번의 실수를 열 번 복사하는 일이 될 수 있습니다.
테스트는 물어본 것만 확인한다
그렇다면 테스트를 많이 만들면 해결될까요.
처음에는 저도 그렇게 생각했습니다. 테스트가 통과하면 구현이 맞다고 판단했습니다.
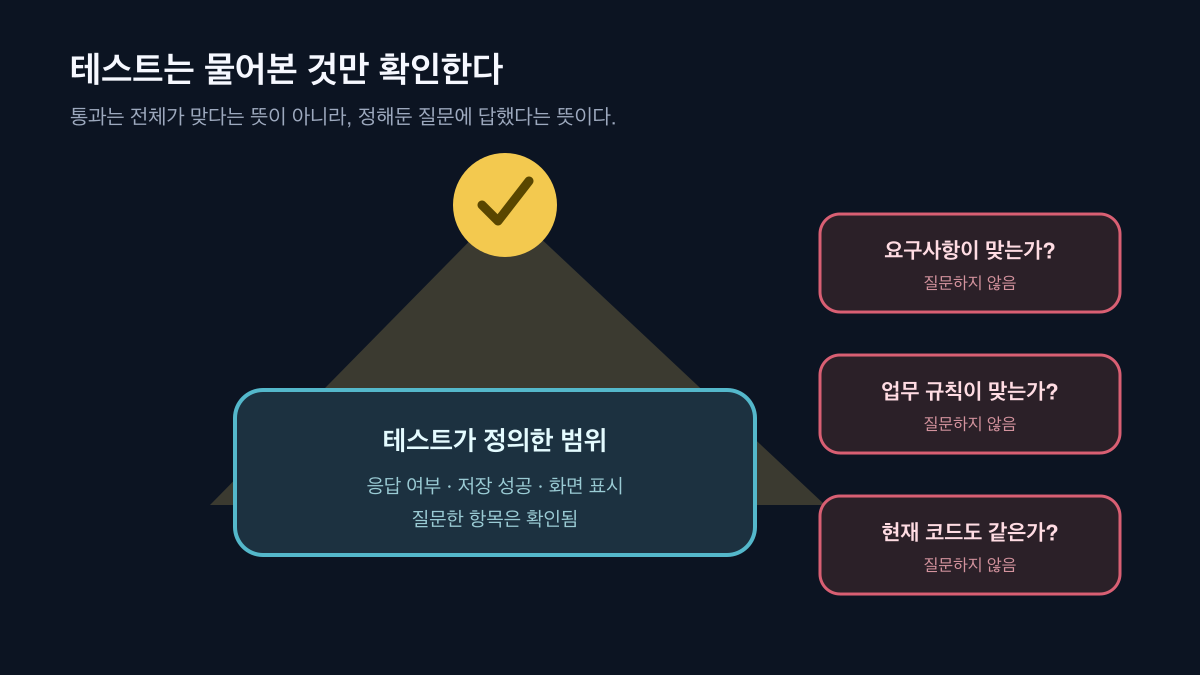
하지만 테스트는 자신이 질문한 것만 확인합니다.
저장에 성공했는지 묻는 테스트는 왜 그 값을 저장해야 하는지 확인하지 않습니다. 화면이 열리는지 묻는 테스트는 사용자가 원하는 정보가 보이는지 확인하지 않습니다. API 응답이 200인지 묻는 테스트는 그 응답이 올바른 업무 규칙을 반영했는지 확인하지 않습니다.
검증하지 않은 영역에서 문제가 생겼는데 기존 테스트가 모두 통과하는 일은 모순이 아닙니다. 애초에 그 테스트가 해당 문제를 질문하지 않았기 때문입니다.
그래서 “테스트를 통과했다”는 말 앞에는 반드시 다른 질문이 필요했습니다.
무엇을 기준으로, 어느 범위까지 확인했는가?
기준과 작업 순서를 섞으면 다시 구현부터 시작한다
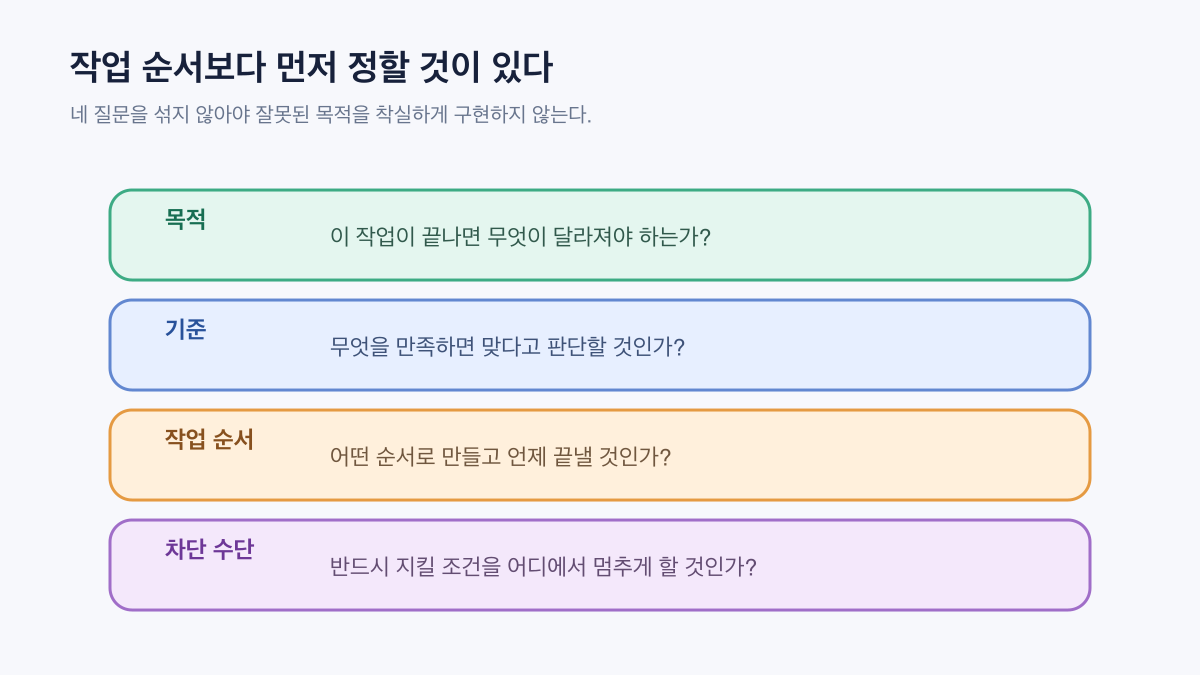
이 문제를 해결하려고 처음에는 작업 순서를 더 자세히 만들려고 했습니다.
설계하고, 문서화하고, 개발하고, 테스트하고, 검증하는 순서를 정하면 나아질 것이라고 생각했습니다.
물론 작업 순서도 필요합니다. 하지만 그보다 먼저 필요한 것이 있었습니다.
왜 이 작업을 하는지, 무엇을 만족해야 하는지, 그 기준은 어디에서 왔는지를 먼저 정해야 했습니다. 이게 없으면 아무리 정교한 작업 순서를 만들어도 잘못된 목적을 착실하게 구현할 뿐입니다.
실제 하네스를 정리하는 과정에서도 저는 여러 번 이 구분을 다시 잡아야 했습니다.
- 참고 자료와 우리가 만들 기준은 다름
- 기준과 작업 순서는 다름
- 목적이 다른 하네스는 분리해야 함
- 시험이 끝난 것과 개발 단계로 넘어간 것은 다름
AI는 이 요소를 쉽게 하나의 절차로 묶었습니다. 하지만 저는 목적과 기준이 먼저 서지 않은 상태에서 작업 흐름부터 확정할 수 없었습니다.
애초에 무엇을 구현하려는지 정하지 않았는데, 어떻게 구현부터 시작할 수 있을까요.
그래서 하네스를 직접 만들기로 했다
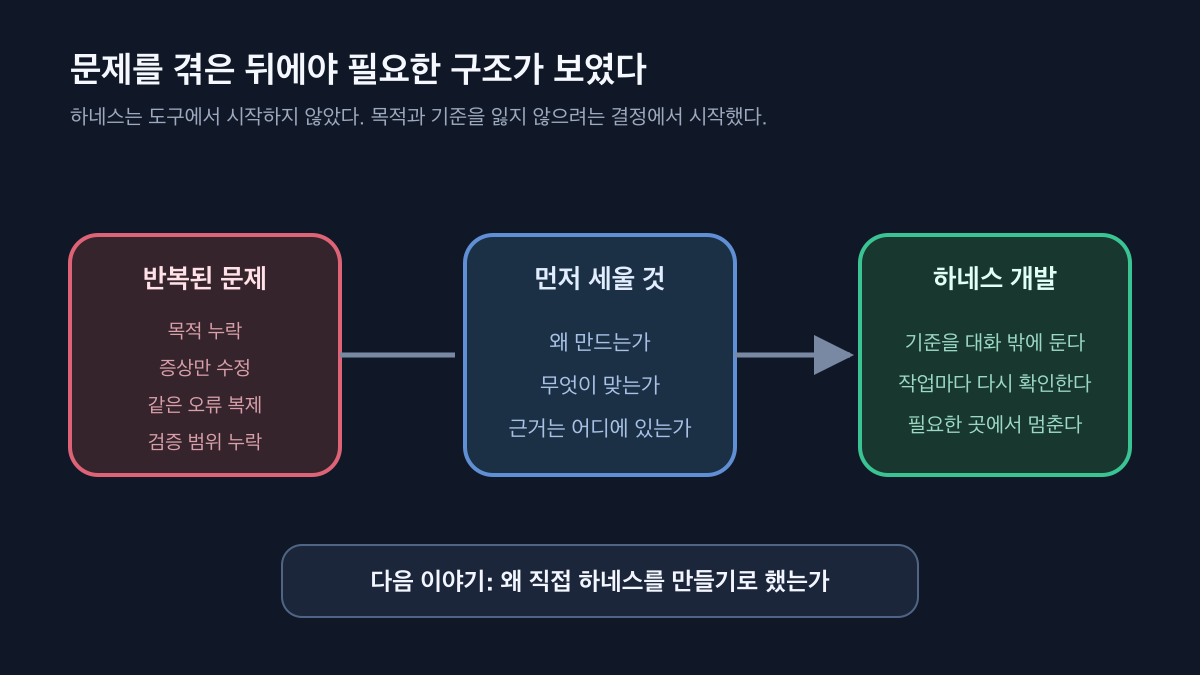
제가 겪은 문제를 다시 모아보면 다음과 같습니다.
- 목적이 정해지기 전에 구현이 시작됨
- 원인을 확인하기 전에 증상을 수정함
- 같은 잘못된 판단을 여러 곳에 반복함
- 테스트가 정의하지 않은 문제는 계속 통과함
- 기준과 작업 순서가 섞이면서 판단 근거가 사라짐
이 문제는 더 긴 프롬프트 하나로 해결하기 어려웠습니다.
대화가 길어지면 앞에서 정한 내용이 약해졌고, 프로젝트가 바뀌면 같은 기준을 다시 설명해야 했습니다. 무엇보다 AI가 지켜야 할 기준을 AI와의 대화 안에만 두면, 그 대화가 끝나는 순간 기준도 함께 사라졌습니다.
그래서 프로젝트 밖에 기준을 세우고, AI가 작업할 때마다 그 기준을 다시 만나게 만드는 구조가 필요하다고 판단했습니다.
제가 하네스를 직접 만들기 시작한 배경입니다.
하네스는 단순히 AI의 행동을 막는 도구가 아닙니다. 목적과 기준을 먼저 세우고, 그 범위 안에서 무엇을 만들 수 있는지 좁혀주는 구조에 가깝습니다.
다음 글에서는 이 문제를 해결하기 위해 어떤 목적을 세웠고, 왜 기존 도구를 조합하는 대신 하네스를 직접 만들기로 했는지 이야기해보려고 합니다.